 뉴스레터


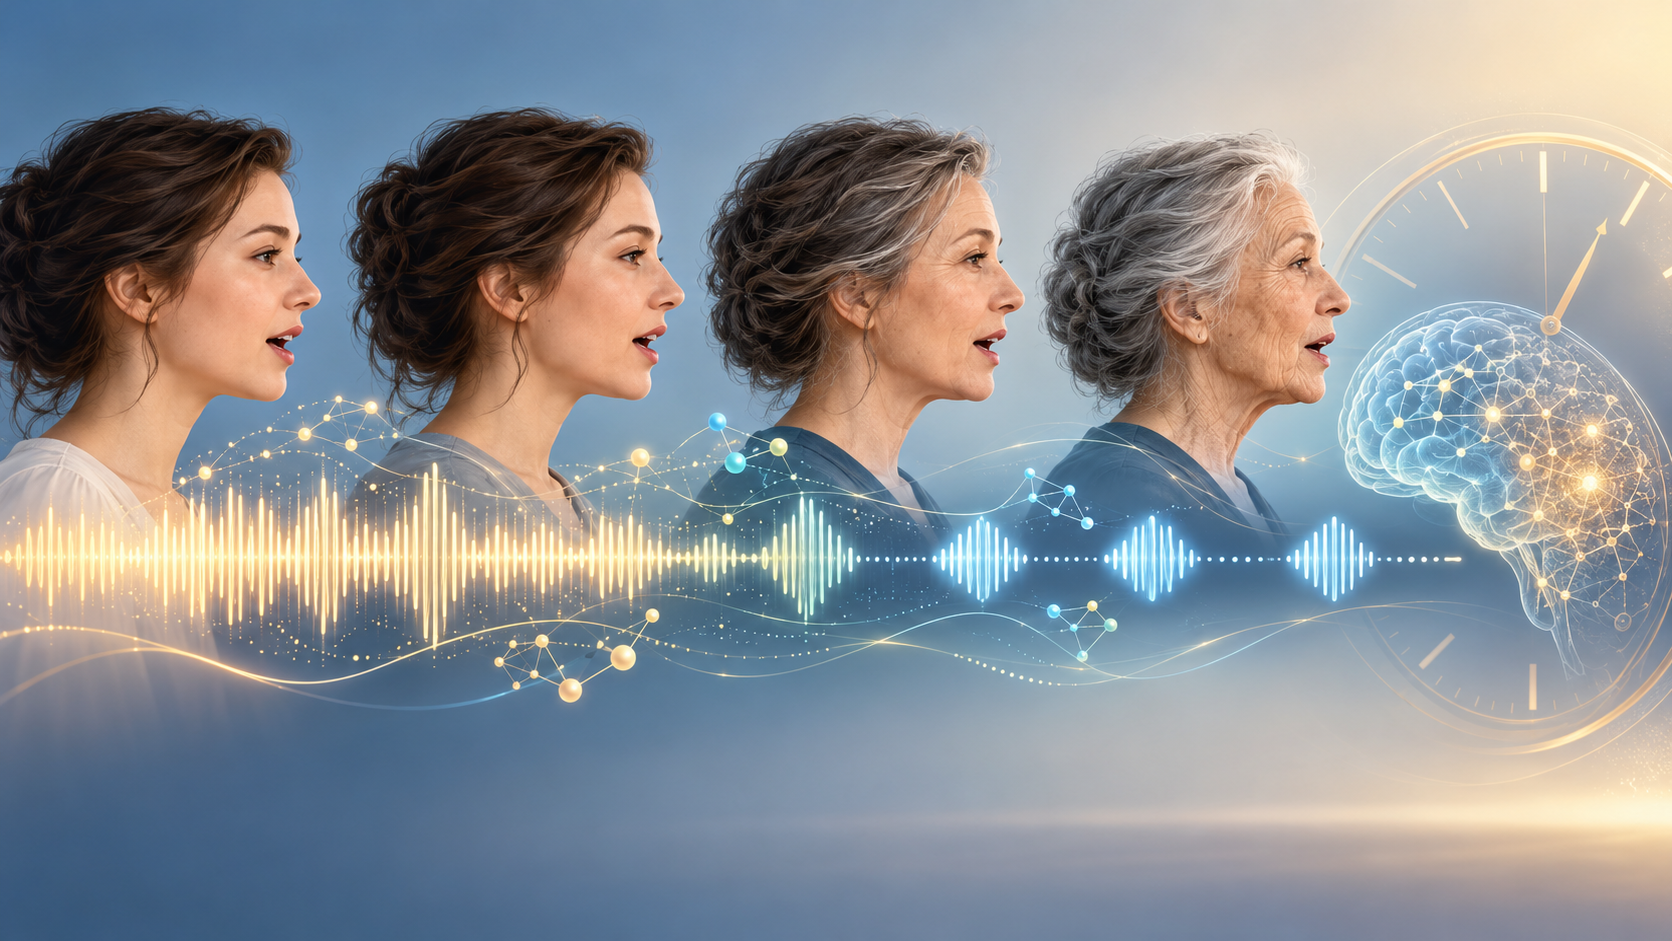
한국과학기술원(KAIST)은 전기및전자공학부 노용만 교수 연구팀이 입술 움직임을 보고 말을 문자로 바꾸는 '시각적 음성 인식'(VSR)의 정확도를 높이는 기술을 개발했다고 15일 밝혔다.
연구팀은 문장의 빈칸을 반복해서 채워나가는 '확산 대형 언어 모델'(DLLM)을 활용해 입 모양이 모호한 부분을 앞뒤 문맥으로 해독하도록 했다.
연구팀은 '처음부터 순서대로 읽기'를 '확실한 부분부터 읽기'로 바꿨다. 입술 움직임이 분명한 단어를 먼저 알아낸 뒤 그 단어들을 단서로 남은 부분을 해독하는 방식이다.
학습 방식도 먼저 영상 속 입술 움직임과 글자 내용을 연결하도록 가르친 뒤 문장의 길이를 학습하도록 두 단계를 나눴다.
실제 말을 해독할 때는 영상 길이를 바탕으로 가능한 문장 길이를 여러 개 추정하고, 각 결과를 비교해 더 신뢰할 만한 문장을 선택하도록 했다.
연구팀이 433시간 분량의 입 모양 영상을 활용해 실증한 결과, 단어 오류율 19.4%를 기록했다.
단어 오류율은 정답 문장과 비교해 단어를 잘못 인식하거나 빠뜨리거나 추가한 정도를 나타내며 낮을수록 성능이 좋다.
이 기술은 소리가 잘 들리지 않는 환경에서 입 모양을 문자로 전달하는 의사소통 보조 기술에 활용될 수 있다. 기계 소음이 큰 산업 현장에서 작업자의 말을 파악하거나, 청각장애인·난청인의 대화를 돕는 기기로 발전시킬 수 있다고 연구팀은 설명했다.
노용만 교수는 "인공지능이 단어를 생성하는 순서를 유연하게 제어하는 것만으로도 시각적 모호성을 지닌 음성 인식의 근본적 한계를 극복할 수 있음을 입증했다"며 "실제 생활과 산업 현장의 다양한 기기에서 신뢰하고 사용할 수 있는 기반을 마련할 것"이라고 말했다.
- 연합뉴스
- 저작권자 2026-11-16 ⓒ ScienceTimes
관련기사